微软发布 MAI-Transcribe-2 后,我们最想知道的是:这个新语音识别模型,值不值得替换产品里已经在用的 ASR?
团队拿了 127 条音频,约 14.4 小时,覆盖中、英、日、韩、西、葡六种语言,把 microsoft/mai-transcribe-2 与豆包,以及不同测试组中的 Whisper、FunASR 做了一轮对比。
我们的判断是:英语、日语值得优先试,中文没有充分理由只凭平均分就换,做字幕更不能只看识别准确率。
MAI-Transcribe-2 的吸引力在哪里#
2026 年 9 月 3 日,微软发布了 MAI-Transcribe-2,提供词级时间戳、说话人区分等能力。官方发布优惠价为每小时音频 0.10 美元,持续到 2026 年底。
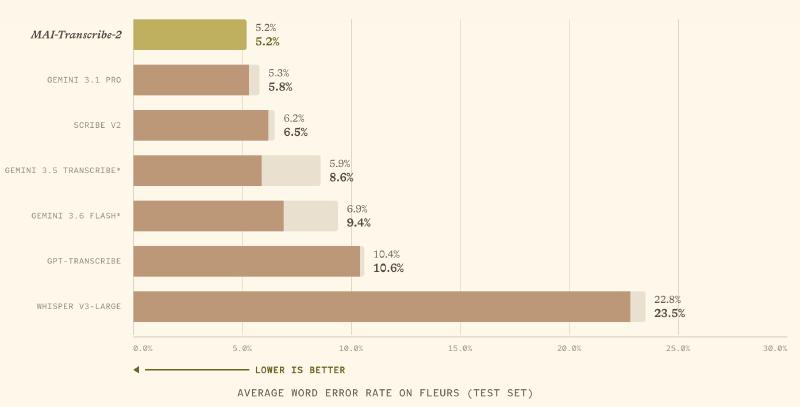
图源:微软官方发布文章。上图为官方基准成绩,与下文团队测试的数据集和评分口径不同,数值不能直接比较。
对做音视频产品的团队来说,价格值得关注,词级时间戳也可能减少后续字幕处理的工作。但这些能力有没有用,得把自己的音频送进去才知道。
这次样本包括日常视频、演讲和中文短剧。中文组测试 MAI、豆包和 FunASR,另外两组测试 MAI、豆包和 Whisper,没有将四套系统放在所有样本上统一排名。
统计说明:下文平均词错误率(WER,越低越好)采用剔除 WER 超过 80% 样本后的结果,只反映本次样本与配置下的表现,不包含完整的失败情况。
对比 Whisper、豆包:先看你做哪种语言#
英语、日语、韩语这组的平均 WER 如下:
| 系统 | 平均 WER |
|---|---|
| MAI-Transcribe-2 | 11.97% |
| Whisper | 14.53% |
| 豆包 | 14.65% |
MAI 的平均值更低,但拆到各语言,优势并不一致。英语、日语是 MAI 领先;韩语则是 Whisper 略低,两者只差 0.11 个百分点。
我们不会因为这 0.11 个百分点就换一个接口。这个差距是否有实际意义,得看具体错了什么,以及换一批音频后是否还能保持。
在西班牙语、葡萄牙语这一组,Whisper 的平均错误率更低。如果主要处理这两种语言,本次测试没有给出放弃 Whisper 的理由。
多语言产品的选型,应该先按语言拆开。一个三种语言的平均分,不能替另外三种语言做决定。
中文短剧:平均分第一,不等于每段都更准#
17 条中文短剧音频中,MAI 的平均 WER 是 22.43%,豆包是 23.54%,FunASR 是 32.74%。
MAI 领先豆包 1.11 个百分点,但豆包的中位数更低。两个指标给出了不同的排序。
这并不矛盾:某个系统在分布中间位置的误差更低,仍可能因为少数高误差样本而被拉高平均值。换到产品里,最需要关心的是这些差异落在哪些输入上。
如果优势来自我们经常处理的复杂对白,那值得换;如果优势只出现在很少遇到的片段上,日常输入并没有改善,就未必值得付出迁移成本。
FunASR 在这组测试中落后较多,但这只能评价本次使用的模型和配置。中文短剧也不能代表会议、口述或所有中文语音识别需求。
我们更倾向于拿这组结果筛选方案,而不是据此宣布中文 ASR 的胜负。
做字幕,识别准确率还不够#
Whisper 在西语、葡语这组的错误率最低,但输出的长句比例也更高。这对转写文稿未必是问题,对字幕却可能意味着额外的断句工作。
文字都对,一整段挤在屏幕上,用户照样要改。句子切得短,时间戳对不上声音,也一样不能直接用。
MAI 的词级时间戳因此很值得关注:它给字幕对齐和编辑提供了更细的输入。但接口能返回时间戳,和时间戳准确到足以交付,是两件需要分别验证的事。本次测试还没有完成这部分体验评估。
我们认为,字幕产品更应该比较“拿到结果后还要改多久”。
这个时间包含改错字、重新断句、调整时间轴。只优化词错误率,可能把识别阶段省下的工作,挪到了字幕编辑阶段。
真正贵的,是整段重做#
平均值还有一个容易掩盖的问题:严重失败。
这次统计排除了 WER 超过 80% 的样本,因此不能用上面的均值判断哪套系统最稳定。如果只是模型识别得太差,这些样本就应该计入产品评估;只有确认数据或标注有问题,才有理由修正或统一排除。
批量处理时,一处错字和整段漏识别的代价差很多。前者可能改几个字就结束,后者要重跑任务,再检查后续字幕。各系统如果剔除了不同样本,单看剔除后的平均分还会让比较失去共同基础。
每小时 0.10 美元的接口价格很吸引人,但它不包含这些返工成本。我们尚未实测完整费用,不能把官方单价直接换算成产品能节省的成本。
MAI-Transcribe-2 值得换吗?#
对于英语、日语转写,我们会把它放进优先试用名单;对于已经用豆包处理中文的产品,1.11 个百分点的平均差距还不足以支持全面迁移;西语、葡语则仍有继续使用 Whisper 的依据。以上判断都限于这轮测试。
至于自动字幕,谁能减少断句、对齐和重做的时间,谁才更值得接入。
我们愿意为更少的人工修改换模型,不愿意只为一张更好看的成绩表换接口。 如果最终还是同一批字幕需要返工,用户不会关心后端的模型名字更新了没有。